Notice: Function wp_enqueue_script was called incorrectly. Scripts and styles should not be registered or enqueued until the wp_enqueue_scripts, admin_enqueue_scripts, or login_enqueue_scripts hooks. This notice was triggered by the jquery handle. Please see Debugging in WordPress for more information. (This message was added in version 3.3.0.) in /mnt/webroot/wandoer/code.wandoer/wp-includes/functions.php on line 6260
RyanWong – 第 14 页 – 豌豆

作者: RyanWong

  • 解决 “building for iOS simulator, but linking in object file built for OSX, for architecture x86_64”

    在升级XCode到版本7以后,使用某些静态库(.a文件),并为IOS模拟器编译时,可能会出现如标题所示错误,提示这个库是为OSX系统的X86_64平台编译的。这可能是XCode版本的一个BUG,在链接静态库时,优先链接了OSX平台下的obj,并抛编译错误。

    xcode error

    为解决此问题,我们在编译静态库时,不要将添加OSX系统下的平台,或者使用lipo将静态库中关于OSX系统平台的内容移除。

    首先使用 “-info”选项查看静态库里包含了哪些平台内容:

    $ lipo -info libuuid.a 
    Architectures in the fat file: libuuid3.a are: armv6 armv7 armv7s i386 arm64 x86_64

    可以看到此静态库中包含了 i386和x86_64两个平台内容。然后使用 “-remove” 将其移除:

    $ lipo libuuid.a -remove i386 -output libuuid.a
    $ lipo libuuid.a -remove x86_64 -output libuuid.a
    $ lipo -info libuuid.a
    Architectures in the fat file: libuuid.a are: armv6 armv7 armv7s arm64

    使用移除OSX平台内容后的静态库再次编译,问题解决。

    但是会出现warning:

    “ld: warning: ignoring file ……/libuuid.a, missing required architecture x86_64 in file ……/libuuid.a (4 slices)”

    可以不用理会。但是在发布或部署到真机的时候,还是需要使用带有x86_64平台的静态库。

  • 了解Poco C++ Poco::Data 数据库基本操作(二)

    Statement

    前面我们提到了Statement,但是到目前为止,我们只使用了session,至少从代码上来看是这样的。

    而实际上,我们已经在使用statement了,只不过它在代码中隐藏了起来。我们来看看Session类中的<<操作符:

    template <typename T>
    Statement operator << (const T& t)
    /// Creates a Statement with the given data as SQLContent
    {
        return _statementCreator << t;
    }

    这里<<操作符创建了一个statement并将其返回。前面例子中我们使用<<操作符创建了statement,但是这个statement并没有分配到变量,一直到”now”部分executed了这个隐藏的statement,然后将其销毁。

    我们将前面的例子拿一个出来修改一下:

    std::string name("zrKing"); 
    Statement stmt = (session << "INSERT INTO tbA VALUES(?)",use(name));
    stmt.execute();
    poco_assert(stmt.done());

    当execute执行以后,数据已经插入了。可以使用stmt.done()来确认操作是否已经完全完成。

    Prepared Statements

    上例中省略的代码now子句创建了一个prepared statement.

    prepared statement 的优势在于性能。我们假设有如下的循环:

    std::string name;
    Statement stmt = (session << "INSERT INTO tbA VALUES(?)", use(name));
    for(int i = 0; i<100; i++)
    {
        name.append("x");
        stmt.execute();
    }

    在上例中,如果不使用prepated statement,我们需要创建和解析Statement 100次。而现在我们只需要创建并解析一次Statement,然后使用占位符匹配不同的值,多次执行来将name插入到数据中。

    当然,对于如何将一系列值插入到数据库,上例的代码并不是最优解。通过Poco::Data与STL容器协作可以更好的解决这个问题。具体的我们将在”STL容器”这一节来讲。 (更多…)

  • 了解Poco C++ Poco::Data 数据库基本操作

    前言

    POCO::Data 是Poco的数据库抽象层,为C++提供统一的结构化数据库访问接口,使得C++以简单而自然的方式访问关系型数据库。使用它可以方便地从多种数据库中存取数据。目前Poco::Data支持的数据库连接类型包括 SQLite,MySQL及ODBC。POCO框架支持扩展,所以你也可以添加其他的本地连接扩展。

    下面是一个使用Poco::Data::SQLite的一个简单例子:

    #include "Poco/Data/Session.h"
    #include "Poco/Data/SQLite/Connector.h"
    #include <vector>
    #include <iostream>
    
    using namespace Poco::Data::Keywords;
    using Poco::Data::Session;
    using Poco::Data::Statement;
    
    struct Person
    {
        std::string name;
        std::string address;
        int         age;
    };
    
    int main()
    {
        //注册SQLite连接器
        Poco::Data::SQLite::Connector::registerConnector();
    
        // 创建传话 session
        Session session("SQLite", "sample.db");
    
        // 删除表
        session << "DROP TABLE IF EXISTS Person", now;
    
        // 网创建表
        session << "CREATE TABLE Person (Name VARCHAR(30), Address VARCHAR, Age INTEGER(3))", now;
    
        // 插入记录
        Person person = 
        {
            "Bart Simpson",
            "Springfield",
            12
        };
    
        Statement insert(session);
        insert << "INSERT INTO Person VALUES(?, ?, ?)",
            use(person.name),
            use(person.address),
            use(person.age);
    
        insert.execute();
    
        person.name    = "Lisa Simpson";
        person.address = "Springfield";
        person.age     = 10;
    
        insert.execute();
    
        // 简单查询
        Statement select(session);
        select << "SELECT Name, Address, Age FROM Person",
            into(person.name),
            into(person.address),
            into(person.age),
            range(0, 1); 
    
        while (!select.done())
        {
            select.execute();
            std::cout << person.name << " " << person.address << " " << person.age << std::endl;
        }
    
        return 0;
    }


    创建会话(Sessions)

    通过Session 构造器可以创建Session:

    Session session("SQLite","./sample.db");

    这个例子创建了一个SQLite类型的session。

    第一个参数是希望创建的Session类型,目前支持的连接类型有”SQLite”,”ODBC”,”MySQL”。

    第二个参数是数据库连接字符串,根据不同的数据库使用不同的连接字符串:

    • 对于Sqlite数据库,数据库路径即可做为连接字符串
    • 对于ODBC数据库,连接字符串类似于 “DSN=MyDSNName”.具体参数请参考ODBC驱动文档
    • 对于MySQL数据,连接字符串由一系列键值对组成,例如 “host=localhist;port=3306;db=mydb;user=thename;password=thepwd;compress=true;auto-reconnect=true”;具体请教参MySQL官方文档。

    存取数据

    单数据集

    假设我们有一个表 tbA,表中有一个字段 fN,插入记录时我们可以这么写:

    std::string name="wandoer"; 
    session << "INSERT INTO tbA VALUES("<<name<<")",now;

    是不是很简单。然而这种写法并不提倡,我们有更好的方式:占位符!使用占位符(placeholders)可以匹配变量和占位符,在执行语句时自动用变量替换占位符。普遍公认的占位符是问号(?),有些数据库也使用冒号(:)来做占位符。具体使用哪一种,请参考所选用数据库的说明文档。

    那么上面的例子可以写做:

    std::string name="wandoer"; 
    session << "INSERT INTO tbA VALUES(?)",use(name), now;

    此例中使用use(name)来匹配占位符。use是Poco::Data::Keywords下提供的关键字,可以将变量和占位符绑定(Binding)。这么做真正的意义,是将变量与SQL语句分隔开,防止SQL注入式攻击。

    从数据库中取数据的操作与之类似。into关键字将数据库返回的值与C++对象匹配起来。并且支持指定默认值以防数据库返回null值。

    std::string name; 
    session << "SELECT fN FROM tbA",into(name),now;
    session << "SELECT fN FROM tbA",into(name,0,std::string("default")),now;

    此处需要注意的是,指定默认值的into,其定义为:into(T& t, const Position& pos, const T& def),使用的是模样类。在有些编译器下,不能隐式转换数据类型,所以需要显示的让第一个参数和第三个参数的数据类型保持一致。

    into还可以和use联合使用:

    std::string name;
    std::string match="wandoer";
    session << "SELECT fN FROM tbA WHERE fN=?",into(name),use(match),now;

    当然,现实中的数据库不会总像例子中这么简单。在一个表中往往有多列,这样需要使用多次into/use关键字:

    std::string firstName("Peter");
    std::string lastName("Junior");
    int age = 0;
    ses << "INSERT INTO PERSON VALUES (?, ?, ?)", use(firstName), use(lastName), use(age), now;
    ses << "SELECT (firstname, lastname, age) FROM Person", into(firstName), into(lastName), into(age), now;

    那么此时尤为重要的,就是into和use的顺序了。第一个占位符使用第一个use,第二个占位符使用第二个use,以此类推。into亦如是。

    (更多…)

  • 仿函数(function object,函数对象)

    引子

    前一篇文章讲到了C++11的新特性lambda表达式。

    lambda表达式的本质是什么呢?为探究这个问题,我们将一段写有lambda表达式的代码反编译,可能会发现一些秘密.

    首先写段程序:

    //#include...
    auto flambda = [](int x,int y)->int{return x + y;};
    int main()
    {
        cout<<flambda(3,2)<<endl;
        return 0;
    }

    在调试该代码时我们打开汇编视图,发现如下代码:

    callq  0x100000d80 <$_0::operator()(int, int) const>
    mov    0x2c4(%rip),%rdi        # 0x100001010
    mov    %eax,%esi

    其中 <$_0::operator()(int, int) const>      即对应原代码中的lambda表达式。这里一串重载了”()”(operator())操作符的代码,即本文将要了解的仿函数。

    Note:  此处的 const  ,也应证了前文 mutable 可变范围 中提到的,lambda的调用运算符为”const-by-value”的

      定义

    仿函数(finctor)是一种早期的叫法,在C++11中,标准的叫法为函数对象(function object)。仿函数是一种行为类似函数、具有函数特性的对象。

    仿函数是一个对象,而不是函数。仿函数的类通过重载函数操作符”()”(operator())来实现函数调用的特性。

    通过下面的例子来简单说明如何使用仿函数

    #include <functional>
    //#include...
    
    class myGreater
    {
    public:
        bool operator()(int x,int y)  //重载调用操作函数
        {return x>y;}
    };
    
    int main()
    {
       greater<int> gt;  //lineA
       cout<<boolalpha<<gt(4,3)<<endl;  //lineB
       cout<<greater<int>()(3,4)<<endl; //lineC
       cout<<myGreater()(5,3)<<endl;    //lineD
        return 0;
    }
    //OUTPUT:
    //true
    //false
    //true

    这个例子中,lineA声明了一个对象。这是一个函数对象,其类(结构)定义在functional文件中,是STL内置的模板类。该类用于比较两个参数的大小。

    lineB则像函数一样直接给该对象传入两个参数。

    lineC是另一种写法。greater<int>() 声明了一个临时对象,然后传入参数(3,4)调用该临时对象。这种写法往往比lineB更加简洁。在STL源码里大量使用了这种写法。

    lineD则是使用自定义的函数对象。

    Note:lineB中使用了boolalpha,是iostream提供的一个操作符,这将使此后的标准输出中,将bool值输出为”true”或”false”,而不是1/0。于其相反的操作为noboolalpha.

    (更多…)

  • lambda 表达式

    LAMBDA简介lambda

    从C++11开始,c++开始支持lambda表达式。

    lambda用来创建一个可以捕获作用域内变量的匿名函数对象的闭包。这通常用来封装传递给算法或异步方法的少量代码块。

    例如,简单实现一个Trim函数,去除字符串里的空格:

    #include <iostream>
    #include <string>
    #include <vector>
    #include <algorithm>
    using namespace std;
    
    string trimall(string str)
    {
        vector<char> vec;
        for_each(str.begin(),str.end(),[&vec](char c){if(!isspace(c)) vec.push_back(c);});
        return string(vec.begin(),vec.end());
    }
    
    int main() {
        std::string str = "   Hi, lam b da!";
        
        std::cout << trimall(str);
        
        return 0;
    }
    
    //OUTPUT:
    //Hi,lambda!

    此例中,

    [&vec](char c){if(!isspace(c)) vec.push_back(c);}

    即是一个lambda表达式。其做为一个匿名函数,被算法  for_each 使用,使得代码更简洁。

    (更多…)

  • Objective-C基础语法 类

     一、类声明

    Objective-C并没有像其他面向对象语言那样提供声明类的专用关键字或者语法,而是用编译处理指令来实现,特征是类声明语句都须以@符号开始

    类声明的编译处理指令以 @interface 开始,以 @end 结尾,在这之间代码便是类属性和方法的声明。

    @interface 类名 : 父类名
            属性声明
    	实例方法声明
    	类方法声明
    @end
    属性声明

    属性是获取和(或)设置类实例状态的接口。

    语法如下:

    @property (可选特性) 属性类型 属性名称

    //TODO 属性的特性可以设置属性的存储主义和其他行为。

    方法声明

    语法如下:

    方法类型 (返回值类型) 方法名部分1:(参数类型1)参数名1 方法名部分2:(参数类型2)参数名2 ...;

    例如:

    - (void) setpointX:(int)x andY:(int)y;
    • 方法类型 -表示该方法为实例方法 +表示该方法为类方法
    • 返回值类型和参数类型放入()中
    • C函数返回值缺省为int型。OC中缺省参数为id型的对象类型。
    • 习惯上类名首字母大写,方法名全部小写​。

    二、类实现

    类的实现要在@implementation这个编译处理指令中进行

    @implementation 类名
    {
          变量声明
    }
    属性定义
    实例方法定义
    @end
    变量声明

    类的实例变量可以在类的接口或实现部分中声明。不过在类的公有接口中声明变量违反了OOP的特性之一—封装。所以最好在类的实现部分声明实例变量。类可以没有实例变量,这时{}可以忽略。

    Object-C提供多种编译器指令设置变量的作用范围(即变量的访问控制):

    • private: 只能在声明它的类中被访问
    • protected: 只能在声明它的类以及其子类中被访问
    • public: 可以被任意代码访问(这会违反类的封装原则)
    • package: 可以被同一个包内的其它类实例或函数访问。这种作用范围通常用于库或框架类。

    当用变量保存对象的时候,应该始终使用指针类型。Objective-C对变量包含的对象支持强弱两种类型。强类型指针的变量类型声明包含了类名。弱类型指针使用id作为对象的类型。弱类型指针常用于类的集合,在集合中对象精确的类型可以是未知的。

    属性定义

    在大多数情况下,属性是由变量支持的,所以,属性定义中会含有属性的getter,setter方法的定义、变量的声明,并在getter/setter方法中使用这个变量。OC提供了多种定义属性的方式:显式定义、关键字补全、自动补全。

    1. 显式定义: 在相应的代码中明确定义属性的访问器(getter,setter)方法。
    2. 关键字补全: 通过使用@synthesize关键字,可以使编译器自动生成属性定义。属性代码会在相应的类实现部分自动补全。
    3. 自动补全: Clang/LLVM(4.2+)是苹果公司推荐使用的OC编译器,他支持对已声明的属性进行自动补全。这意味着编译器可以自动补全以下已声明的属性:没有使用关键字(如@synthesize)进行代码补全的属性、不是通过@dynamic指令自动生成的属性。 编译器会自动补全已声明的方法和相应的变量。

    (更多…)

  • netsh 配置 Windows 网络


    单位使用的是有线局域网络,通过单位路由连接公网。同时配备了一个VPN无线网络用作平时翻墙用。但是在连接到无线VPN网络以后,需要断开本地网络才能够上网;断开VPN网络后需要再次连接本地网络才能上网。太麻烦了。故写一个脚本来配置网络。主要使用 netsh 命令

    脚本:

    netsh wlan connect name=vpn
    netsh interface set interface name="本地连接" admin=DISABLE

    这里的“vpn”指无线网配置文件,通过下面的方法导出:

    连接到VPN,并导出配置文件

    netsh wlan export profile name="<wireless_name>" folder="<path>"

    wireless_name 可以为无线网 SSID。

    注意使用 admin 参数时需要有管理员权限。(脚本文件使用管理员权限运行)


  • 使用 RasterIO 读取影像

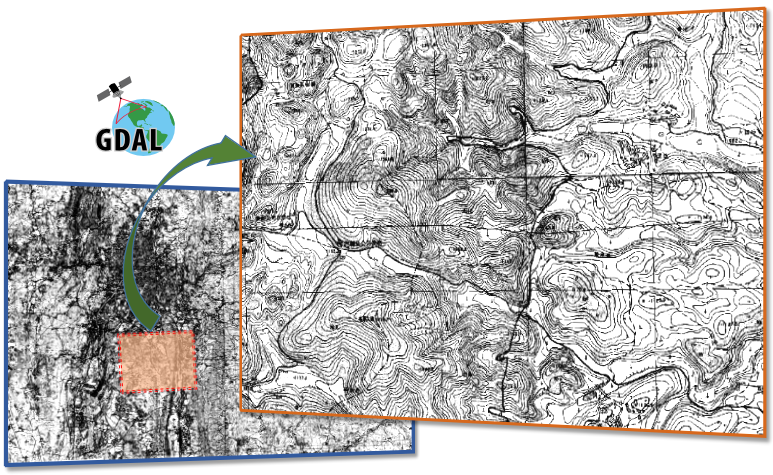
    gdalbaner当我们使用 GDAL  从栅格数据(RasterData)影像中读写数据的时候,我们最常使用的方法就是 RasterIO。 GDAL 在 GDALDataset 类和 GDALRasterBand 类中都提供了 RasterIO 方法。在这两个类中,RasterIO 函数的差别不大。下面我们通过一个实例来具体了解如何使用 RasterIO

     原型

    在 GDALDataset 中,RasterIO  方法的定义如下:

    CPLErr GDALDataset::RasterIO(GDALRWFlag         eRWFlag,
    	int     nXOff,
    	int     nYOff,
    	int     nXSize,
    	int     nYSize,
    	void *  pData,
    	int     nBufXSize,
    	int     nBufYSize,
    	GDALDataType    eBufType,
    	int     nBandCount,
    	int *   panBandMap,
    	int     nPixelSpace,
    	int     nLineSpace,
    	int     nBandSpace
    )

    下面我们来了解各个参数的意义:

    eRWFlag
    它用来指示 RasterIO 的操作方式,读,还是写。GDALRWFlag 枚举有两个值, GF_Read = 0 为读取数据, GF_Write = 1  为写数据。

    nXOff,nYOff
    它用来指示 RasterIO 在影像上操作(读或写)范围的起始坐标。在影像中,左上角的坐标为 (0,0)。

    nXSize,nYSize
    它用来指示 RasterIO 在影像上操作范围的大小。nXSize为宽,nYSize为高。 它以 (nXOff,nYOff)为起点,决定了操作影像的范围的大小。

    pData
    这是一个指针,指向缓存数据块。如果 eRWFlag 为 GF_Write,函数会将 pData 中的数据写入影像,如果为 GF_Read, 那么函数会将从影像中取得的数据写入到 pData 中。 pData 为 void* 类型,它真实的数据类型将由参数 eBufType 决定。
    由于 pData 为 void* 类型,所以它的大小一般使用 字节(byte) 来作单位。它的大小需要最底满足缓冲区的大小。即 缓冲区内存块大小 = 缓冲区长 X 缓冲区宽 X 波段数 X 每波段数据元大小 。用参数来表示:

    //GDALGetDataTypeSize返回数据类型所占位数,故需要除以 8 
    int nDataSize = nBufXSize * nBufYSize * nBandCount * GDALGetDataTypeSize(eBufType) / 8

    nBufXSize,nBufYSize
    它用来指定缓冲区的宽高。这两个参数配合 nXSize,nYSize 来实现对影像的缩放。例如,如果 nBufXSize > nXSize,即缓存区宽度比影像操作区宽度大,那么读取数据时,将得到一个在 X 方向放大的缓冲数据。反之则得到缩小的缓冲数据。
    值得注意的是,在读取并缩小影像时,GDAL 将自动分析金字塔(Overviews)中数据,选取合适的金字塔层来来读取数据。所以建立合适的金字塔,对读取影像的效率的很大帮助。

    eBufType
    它也是一个枚举,用来指示操作的数据类型。如果它与 GDALRasterBand 的数据类型不一致,则 RasterIO 将会做类型转换。需要注意的是,将数据从较大的单位向较小的单位进行转换时,RasterIO 会将数据截取而不是比例缩小。例如从 GDT_Int16(Thirty two bit unsigned integer)转为 GDT_Byte(Eight bit unsigned integer)时,超出 255 的部分将会被直接丢弃。

    nBandCount,panBandMap
    nBandCount为要操作的波段数。panBandMap则为读写的波段的顺序,即我们可以先读取哪一个波段,后读取哪一个波段。它是一个 int 型数组,内容为波段编号,大小为 nBandCount。这个参数可以为 NULL,这样将默认顺序使用影像的前 nBandCount 个波段来读写。需要注意的是,波段编号是从 1 开始的。 (更多…)